موقف من الحياة اليومية
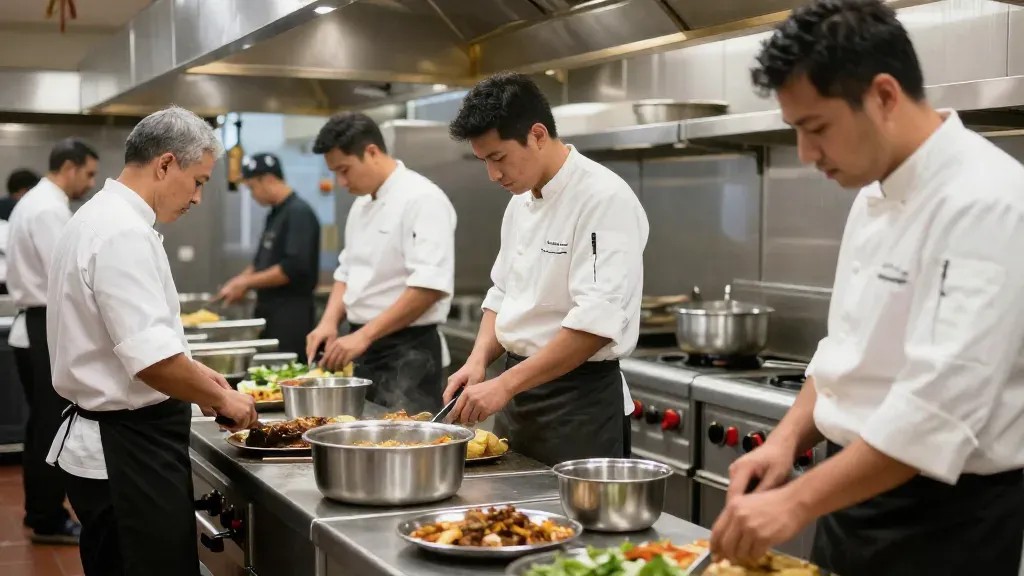
مطعم عنده طلب عزومة كبيرة. لو فيه طباخ واحد، مهما كان سريع، هياخد وقت طويل. فصاحب المطعم جاب 10 طباخين.
الخضار اتقطّع 10 مرات أسرع. بس فيه حاجات ما تتقسمش: الصوص لازم يتعمل على النار بعد ما اللحمة تخلص، ومحدش يقدر يسرّعه. فالعزومة ما خلصتش أسرع 10 مرات.
ده بالظبط اللي بيحصل في المعالجات الحديثة: Cores كتير، بس الفايدة ليها حدود.
خلاصة سريعة
- زيادة سرعة الـ Clock وقفت بسبب الحرارة، وده اسمه Power wall، فالمصممين بدأوا يحطوا أكتر من Core في نفس الشريحة من منتصف الـ 2000s.
- Flynn قسّم الأجهزة حسب عدد التعليمات والبيانات اللي بتتعالج في نفس الوقت: SIMD (زي الـ GPU) وMIMD (زي المعالجات متعددة الـ Cores) هم الأهم النهارده.
- قانون Amdahl: الجزء اللي لازم يتنفذ بالترتيب في البرنامج بيحدد أقصى تسريع، مهما زوّدت الـ Cores.
ببساطة
فيه طريقتين تسرّع بيهم الشغل:
- تسرّع العامل: تخلّي الطباخ نفسه أسرع. وده زي زيادة الـ Clock، ووقف عند حد معيّن بسبب الحرارة.
- تزوّد العمال: تجيب طباخين أكتر يشتغلوا مع بعض. وده الـ Parallelism (التوازي).
بس الطريقة التانية محتاجة الشغل نفسه يتقسم. والجزء اللي ما يتقسمش هو اللي بيحدد إنت هتكسب قد إيه.
بالتفصيل
1 - ليه وصلنا للـ Multicore؟
لسنين طويلة، المعالجات كانت بتسرع عن طريق زيادة الـ Clock وتصميمات أعقد:
- Intel 8080 سنة 1974: 2 MHz.
- Pentium Pro سنة 1995: 150 MHz.
- Pentium 4 سنة 2000: 1.3 GHz.
- IBM z10 في أواخر الـ 2000s: 4.4 GHz.
وبعدها الزيادة وقفت تقريبًا، لأن السرعة الأعلى محتاجة كهربا أكتر وبتطلّع حرارة صعب تتشال. الحد ده اسمه Power wall (جدار القدرة).
فالحل: بدل Core واحد أسرع، حط كذا Core في نفس الشريحة، وده بدأ من منتصف الـ 2000s.
وفيه ملاحظة قديمة اسمها Moore’s Law: Gordon Moore لاحظ سنة 1975 إن عدد الـ Transistors في الشريحة بيتضاعف كل سنتين تقريبًا. والـ Transistors الزيادة دي بتدّي المصممين مساحة لدوائر أكتر للحساب والتخزين.
2 - تقسيم Flynn
Flynn قسّم الأجهزة حسب عدد تيارات التعليمات وعدد تيارات البيانات اللي بتتعالج في نفس الوقت:
- SISD (تعليمة واحدة، بيانات واحدة): المعالج بينفذ تعليمة واحدة على بيانات واحدة. أغلب المعالجات قبل منتصف الـ 2000s كانت كده.
- SIMD (تعليمة واحدة، بيانات كتير): نفس التعليمة على بيانات كتير في نفس الوقت. وأشهر مثال الـ GPU.
- MISD (تعليمات كتير، بيانات واحدة): تعليمات مختلفة على نفس البيانات. اتعملت للأنظمة اللي ما ينفعش تغلط، زي برامج التحكم في الطيران في مكوك NASA، ونادرة النهارده.
- MIMD (تعليمات كتير، بيانات كتير): كل وحدة بتنفذ تعليماتها على بياناتها. وده الأكثر انتشارًا، وأي كمبيوتر فيه معالج Multicore هو MIMD.
3 - الـ Multicore والـ Hardware multithreading
الـ Multicore: كل Core معالج كامل، ونظام التشغيل بيوزّع الشغل عليهم.
- يقدر يشغّل برامج مختلفة في نفس الوقت، كل واحد على Core.
- لكن البرنامج الواحد ما يسرعش غير لو مكتوب يتقسم لأجزاء متوازية اسمها Threads.
الـ Hardware multithreading: Core واحد شايل أكتر من Thread، وكل Thread ليه Registers خاصة بيه.
- Interleaved: الـ Core بيبدّل بين الـ Threads بسرعة، ومش بينفذهم في نفس الدورة.
- Simultaneous (SMT): في الـ Cores اللي فيها أكتر من وحدة تنفيذ، تعليمات من أكتر من Thread تتنفذ في نفس الدورة.
ومعالجات زي AMD Zen ومعالجات Intel اللي فيها Hyper-Threading بتدعم Thread-ين لكل Core، زي ما شفنا في مقال الـ Cores والـ Threads.
وكل Core عنده L1 خاصة بيه، وعلشان كده محتاجين Cache coherence، زي ما شرحنا في مقال الـ Cache.
4 - الـ GPU: آلاف المعالجات الصغيرة
الـ GPU اتعمل أصلًا للرسوم، وفيه آلاف المعالجات الصغيرة المتخصصة. وطريقة شغله اسمها SIMT (Single Instruction, Multiple Threads)، ودي نوع من الـ SIMD: نفس التعليمة بتتنفذ مع بعض بالظبط، وده اسمه Lockstep، على Threads كتير، كل واحد على بيانات مختلفة.
مثال: تحويل صورة ملونة لأبيض وأسود. كل Thread مسؤول عن Pixel واحد، وكلهم بينفذوا نفس الخطوات في نفس الوقت.
ومن منتصف الـ 2000s، الباحثين بدأوا يستخدموا الـ GPU في حسابات عامة مش رسوم بس، وده اسمه GPGPU.
إمتى الـ GPU مش هيفيد؟
- لو البيانات محتاجة تتنقل كتير بين ذاكرة المعالج وذاكرة الـ GPU، النقل ممكن ياكل الفايدة.
- لو الأجزاء محتاجة تستنى بعض كتير.
5 - شرائح متخصصة
الـ Heterogeneous computing (الحوسبة غير المتجانسة) معناها إن الكمبيوتر بيستخدم أنواع مختلفة من وحدات المعالجة مع بعض، وممكن كل نوع يبقى ليه ISA مختلفة. وأمثلة:
- الـ TPU (Tensor Processing Unit): شريحة من Google متصممة مخصوص، يعني ASIC، علشان تسرّع الـ Machine learning، ومعمولة للعمليات الكبيرة على المصفوفات.
وجواها وحدة للمصفوفات اسمها MXU، وهي Systolic array (شبكة حسابات) مقاسها
128 × 128. ومش مناسبة للبرامج اللي فيها تفرّعات كتير أو محتاجة دقة عالية في الكسور. - الـ FPGA: شريحة بوابات تتبرمج من جديد، زي ما شفنا في مقال الـ Logic Gates.
والـ Chiplets: بدل شريحة واحدة كبيرة، المعالج بيتعمل من كذا شريحة صغيرة في نفس الغلاف، متوصلين ببعض. وفيه معيار مفتوح لتوصيلهم اسمه UCIe (Universal Chiplet Interconnect Express)، وآخر إصدار منه UCIe 3.0.
6 - قانون Amdahl: حدود التوازي
سنة 1967، Gene Amdahl من IBM قال: أي برنامج فيه:
- جزء يتقسم على الـ Cores (P).
- وجزء لازم يتنفذ بالترتيب (S).
ومهما زوّدت الـ Cores، الجزء S بياخد نفس الوقت، وفي الآخر هو اللي بيتحكم.
مثال: برنامج بياخد 10 ثواني على Core واحد، و90% منه يتقسم:
| عدد الـ Cores | الجزء المتسلسل | الجزء المتوازي | الوقت الكلي | التسريع |
|---|---|---|---|---|
| 1 | 1 ثانية | 9 ثواني | 10 ثواني | 1 |
| 10 | 1 ثانية | 0.9 ثانية | 1.9 ثانية | 5.26 |
| 100 | 1 ثانية | 0.09 ثانية | 1.09 ثانية | 9.17 |
| 1000 | 1 ثانية | 0.009 ثانية | 1.009 ثانية | 9.91 |
مهما زوّدت، التسريع ما يعدّيش 10، لأن الثانية المتسلسلة ثابتة. والقاعدة: أقصى تسريع = 1 ÷ S. ولو 99% من البرنامج يتقسم، أقصى تسريع 100 مرة، حتى لو عندك مليون Core.
ومقياسين تانيين:
- Speedup (التسريع) = الوقت على Core واحد ÷ الوقت على c Core. مثلًا 60 ثانية بقت 30 على 2 Cores: التسريع 2.
- Efficiency (الكفاءة) = التسريع ÷ عدد الـ Cores. نفس الـ 30 ثانية بس على 4 Cores: الكفاءة 0.5، يعني نص قوة الـ Cores ضايعة.
وفيه برامج صعب تتقسم أصلًا، لأن كل خطوة معتمدة على اللي قبلها، زي حساب أرقام Fibonacci اللي كل رقم فيها محتاج الرقمين اللي قبله.
أخطاء شائعة
- «8 Cores يعني أي برنامج أسرع 8 مرات»: لأ، البرنامج لازم يتقسم، والجزء المتسلسل بيحدد الأقصى.
- «الـ Clock لسه بيزيد كل سنة زي زمان»: الزيادة وقفت تقريبًا بسبب الـ Power wall، والتحسن بقى من الـ Cores والتصميم.
- «الـ GPU أسرع من الـ CPU في كل حاجة»: الـ GPU ممتاز في الشغل اللي نفس الخطوات على بيانات كتير، ومش في كل حاجة.
- «Hyper-Threading يعني Cores حقيقية زيادة»: ده Core واحد شايل أكتر من Thread.
- «MIMD نوع نادر»: بالعكس، هو الأكثر انتشارًا النهارده.
المصطلحات
- التوازي (Parallelism): تنفيذ أكثر من عملية في الوقت نفسه.
- جدار القدرة (Power wall): حد زيادة سرعة الساعة بسبب الحرارة واستهلاك الكهرباء.
- معالج متعدد الأنوية (Multicore processor): شريحة فيها أكثر من نواة معالجة كاملة.
- تعليمة واحدة وبيانات متعددة (SIMD): تنفيذ التعليمة نفسها على بيانات كثيرة في الوقت نفسه.
- تعليمات متعددة وبيانات متعددة (MIMD): وحدات تنفذ تعليمات مختلفة على بيانات مختلفة.
- التعدد الخيطي في العتاد (Hardware multithreading): نواة واحدة تحمل أكثر من خيط تنفيذ.
- الحوسبة غير المتجانسة (Heterogeneous computing): استخدام أنواع مختلفة من وحدات المعالجة معًا.
- الشرائح الصغيرة (Chiplets): أجزاء صغيرة تُجمع في غلاف واحد لتكوين معالج.
- قانون أمدال (Amdahl’s Law): القانون الذي يحدد أقصى تسريع بحجم الجزء المتسلسل من البرنامج.
اختبر نفسك
برنامج 90% منه يتقسم على الـ Cores. أقصى تسريع ممكن؟
10 مرات.
الجزء المتسلسل 10%، وأقصى تسريع 1 ÷ 0.1 = 10، مهما زوّدت الـ Cores.
إظهار الإجابة
الإجابة الصحيحة: 10 مرات
10 مرات.
الجزء المتسلسل 10%، وأقصى تسريع 1 ÷ 0.1 = 10، مهما زوّدت الـ Cores.
الـ GPU بيشتغل بأنهي نوع في تقسيم Flynn؟
SIMD.
نفس التعليمة بتتنفذ مع بعض على بيانات كتير، والـ GPU بيستخدم نوع منها اسمه SIMT.
إظهار الإجابة
الإجابة الصحيحة: SIMD (أو SIMT)
SIMD.
نفس التعليمة بتتنفذ مع بعض على بيانات كتير، والـ GPU بيستخدم نوع منها اسمه SIMT.
ليه المصممين اتجهوا للـ Multicore بدل زيادة الـ Clock؟
الـ Power wall.
زيادة الـ Clock بقت بتحتاج كهربا وبتطلّع حرارة كتير، فالحل بقى Cores أكتر.
إظهار الإجابة
الإجابة الصحيحة: لأن السرعة الأعلى بتطلّع حرارة وبتحتاج كهربا صعب التعامل معاها
الـ Power wall.
زيادة الـ Clock بقت بتحتاج كهربا وبتطلّع حرارة كتير، فالحل بقى Cores أكتر.