موقف من الحياة اليومية
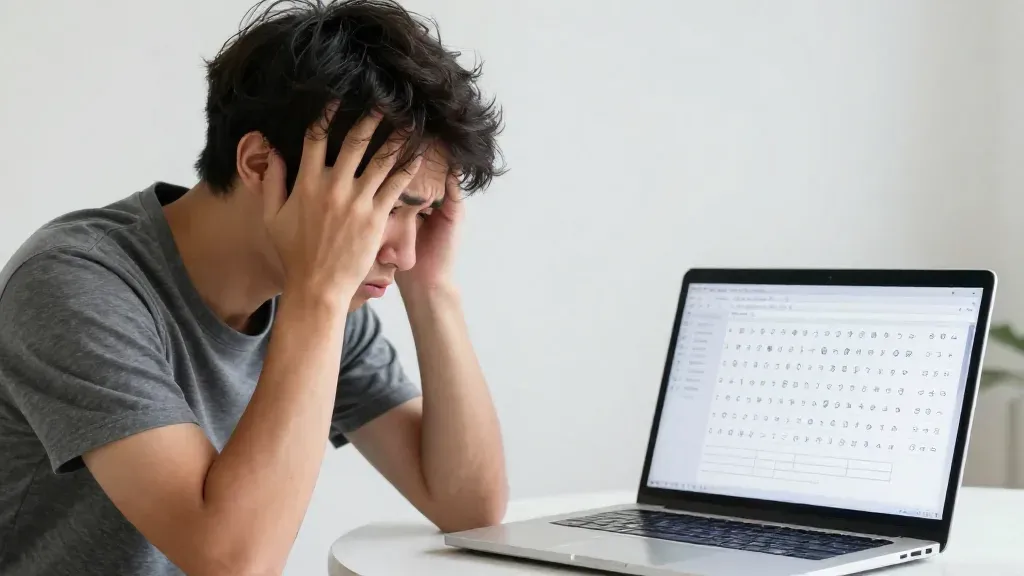
صاحبك بعتلك ملف فيه أسماء الطلبة، فتحته لقيت الكلام شكله كده:
عربي
بدل كلمة «عربي»!
أول حاجة هتيجي في بالك: «الملف باظ».
لكن الحقيقة إن الملف سليم تمامًا، وكل البيانات اللي فيه موجودة.
المشكلة إن البرنامج اللي فتحت بيه الملف قراه بلغة غلط.
زي ما تدّي حد جواب مكتوب بالشفرة، وهو بيفكّه بمفتاح شفرة تانية.
في المقال ده هتفهم «الشفرة» دي: إزاي الكمبيوتر بيحوّل الحروف لأرقام، وليه العربي بالذات بيتلخبط أحيانًا.
خلاصة سريعة
- الكمبيوتر بيخزّن كل حرف على شكل رقم، والاتفاق اللي بيحدد رقم كل حرف اسمه Character Encoding (ترميز الحروف).
- Unicode جدول عالمي بيدّي كل حرف في كل لغات العالم رقم ثابت، وUTF-8 هي الطريقة الأشهر لتخزين الأرقام دي، وفيها الحرف العربي بياخد 2 بايت.
- الرموز الغريبة اللي زي
عربيبتظهر لما بيانات محفوظة بـ Encoding تتقري بـ Encoding تاني.
البيانات سليمة، بس اتقرت غلط.
ببساطة
تخيّل إن عندك قاموس شفرة: كل حرف قصاده رقم.
إنت بتكتب رسالة وتحوّلها لأرقام بالقاموس ده، وصاحبك بيرجّعها حروف بنفس القاموس.
طول ما إنتوا الاتنين معاكم نفس القاموس، الرسالة بتوصل سليمة.
لكن لو صاحبك استخدم قاموس تاني، هيطلّع حروف غلط، مع إن الأرقام نفسها ما اتغيرتش.
وده بالظبط اللي بيحصل في الكمبيوتر: «القاموس» اسمه الـ Encoding (الترميز)، والقاموس العالمي اللي معظم الأجهزة والمواقع بتستخدمه النهارده هو Unicode مع UTF-8.
بالتفصيل
الكمبيوتر بيفهم أرقام بس
فاكر من مقال النظام الثنائي إن الكمبيوتر بيخزّن كل حاجة على شكل 0 و1؟
يعني ما ينفعش يخزّن حرف «ب» زي ما هو.
لازم الأول نتفق إن «ب» = رقم معيّن، وبعدين الرقم ده يتخزن بالثنائي.
الاتفاق ده اسمه Character Encoding (ترميز الحروف)، أو باختصار Encoding.
والـ Encoding هو الطريقة اللي بتحوّل بيها الحروف لبايتات علشان الكمبيوتر يتعامل معاها.
ASCII: البداية (من غير عربي)
من أقدم الاتفاقات وأشهرها ASCII.
واتعتمد سنة 1969 لتبادل البيانات بين الأجهزة.
ASCII بيستخدم 7 بت بس لكل حرف.
ولأن 2^7 = 128، يبقى فيه 128 رمز بس: الحروف الإنجليزية الكبيرة والصغيرة، والأرقام، وعلامات الترقيم، وشوية رموز تحكم.
مثلًا، حرف A رقمه 65 في ASCII.
المشكلة: 128 رمز بالكتير يكفوا الإنجليزي، لكن مافيهمش ولا حرف عربي، ولا صيني، ولا أي لغة تانية.
علشان كده كل منطقة في العالم عملت Encoding خاص بيها لفترة طويلة، ومن هنا بدأت اللخبطة: نفس الرقم معناه حرف في Encoding، وحرف تاني خالص في Encoding تاني.
Unicode: جدول واحد لكل اللغات
الحل كان Unicode: جدول عالمي واحد، كل حرف في كل لغة فيه ليه رقم ثابت مش بيتغير.
الرقم ده اسمه Code Point (نقطة الترميز)، وبيتكتب بـ U+ وبعدها رقم بالنظام السداسي عشر.
ودي أمثلة من جدول الحروف العربية في Unicode:
| الحرف | رقمه في Unicode |
|---|---|
| ا (ألف) | U+0627 |
| ب (باء) | U+0628 |
| ل (لام) | U+0644 |
| ء (همزة) | U+0621 |
والحروف العربية الأساسية موجودة في منطقة من الجدول من U+0600 لـ U+06FF.
وآخر إصدار هو Unicode 18.0 اللي اتنشر في 16 سبتمبر 2026، وفيه 172,808 رمز.
والرقم ده بيزيد مع كل إصدار جديد.
UTF-8: إزاي الأرقام بتتحول لبايتات
UTF-8 هي الطريقة الأشهر لتخزين أرقام Unicode.
وفكرتها الذكية إن الحرف مش لازم ياخد نفس عدد البايتات.
الحرف بياخد من 1 لـ 4 بايت حسب رقمه:
| نوع الحرف | مثال | عدد البايتات | البايتات |
|---|---|---|---|
| حرف إنجليزي | A | 1 | 41 |
| حرف عربي | ا | 2 | D8 A7 |
| إيموجي | 😀 | 4 | F0 9F 98 80 |
ولاحظ حاجة مهمة: حرف A في UTF-8 = 41 بالسداسي، يعني 65، نفس رقمه في ASCII بالظبط.
والحروف الـ 128 بتوع ASCII بتتخزن في UTF-8 زي ما هي.
علشان كده أي ملف ASCII قديم هو أصلًا ملف UTF-8 سليم.
وده معناه إيه بالنسبالك؟
كلمة عربية من 4 حروف زي «عربي» بتاخد 8 بايت، والكلمة الإنجليزية من 4 حروف زي «word» بتاخد 4 بايت بس.
الجدول الكامل
الـ UTF-8 بقى معيار رسمي في نوفمبر 2003 (RFC 3629)، والجدول الكامل بيقول كل مدى من أرقام Unicode بياخد كام بايت:
| أرقام Unicode | عدد البايتات |
|---|---|
من U+0000 لـ U+007F (حروف ASCII) | 1 |
من U+0080 لـ U+07FF (ومنها الحروف العربية الأساسية) | 2 |
من U+0800 لـ U+FFFF | 3 |
من U+10000 لـ U+10FFFF (زي الإيموجي 😀 ورقمه U+1F600) | 4 |
وأكبر رقم في Unicode هو U+10FFFF، يعني فيه مكان لـ 1,114,112 رقم.
UTF-8 مش الطريقة الوحيدة
فيه طرق تانية لتخزين نفس الأرقام، زي UTF-16 وUTF-32. التلاتة بيخزّنوا نفس جدول Unicode، بس بعدد بايتات مختلف لكل حرف. لكن على الويب، UTF-8 هو المعيار، زي ما هنشوف دلوقتي.
UTF-8 هو المعيار على الويب
- النصيحة لكل اللي بيعملوا مواقع إنهم يستخدموا UTF-8، وإن برامج الكتابة تستخدمه تلقائيًا في أي ملف جديد.
- ومعيار الـ Encoding اللي المتصفحات بتتبعه بيعتبر UTF-8 هو المناسب لتبادل النصوص، وبيطلبه في أي صيغ أو Protocols جديدة.
وموقعنا ده نفسه مكتوب بـ UTF-8.
ليه العربي بيظهر رموز غريبة؟
دلوقتي نقدر نحل لغز الموقف اللي في أول المقال:
1 - الكلمة اتحفظت بـ UTF-8.
كلمة «ال» مثلًا اتخزنت كـ 4 بايتات: D8 A7 D9 84.
2 - البرنامج اللي فتح الملف افتكر إنه Encoding تاني.
مثلًا Encoding غربي قديم اسمه Windows-1252، وده كل حرف فيه بايت واحد بس.
3 - كل بايت اتقرا على إنه حرف لوحده: D8 بقت Ø، وA7 بقت §، وD9 بقت Ù، و84 بقت „.
النتيجة: «ال» بتظهر ال.
علشان كده لو شفت كلام عربي ظاهر رموز غريبة كتير فيها Ø وÙ، غالبًا ده نص UTF-8 بيتقري بـ Encoding غربي قديم.
البيانات نفسها سليمة، والحل إن البرنامج يقراها بالـ Encoding الصح.
حاجات مميزة في العربي
1 - العربي بيتكتب من اليمين للشمال، والحروف متصلة.
والحرف الواحد شكله بيتغير حسب مكانه: لوحده، أو في أول الكلمة، أو في نصها، أو في آخرها.
خد حرف الهاء مثلًا: «ه» لوحدها، و«هـ» في الأول، و«ـهـ» في النص، و«ـه» في الآخر.
2 - لكن Unicode بيدّي الحرف رقم واحد بس، مهما اختلفت أشكاله.
والخط اللي على الشاشة هو اللي بيختار الشكل المناسب وقت العرض.
يعني الهاء في كل أشكالها متخزنة بنفس الرقم.
3 - التشكيل رموز منفصلة.
الفتحة والضمة والكسرة والسكون وغيرهم ليهم أرقام خاصة بيهم في Unicode، من U+064B لـ U+0652، وبيتخزنوا بعد الحرف كرموز مستقلة.
علشان كده «كَتَبَ» و«كتب» مختلفين في البايتات، مع إن الحروف واحدة.
وده السبب إن البحث في موقعنا معمول بحيث يتجاهل التشكيل، علشان تلاقي الكلمة سواء كتبتها مشكّلة أو لأ.
4 - الأرقام ليها 3 مجموعات في Unicode.
الأرقام 0-9 اللي بنستخدمها في الموقع ده اسمها في Unicode European digits (أرقام أوروبية)، وبتُستخدم في العالم كله النهارده.
والأرقام اللي بتُستخدم في أغلب العالم العربي، اللي بنسميها «الأرقام الهندية»، اسمها Arabic-Indic digits، ومكانها في Unicode من U+0660 لـ U+0669.
وفيه مجموعة تالتة اسمها Eastern Arabic-Indic digits، وبتُستخدم في أفغانستان والهند وإيران وباكستان.
وUnicode اختار الأسماء دي لأن الأسماء التقليدية كانت هتعمل لخبطة: نفس الأرقام اللي بنسميها «هندية» بتتسمى في أوروبا «عربية».
5 - الكلام الإنجليزي جوه الجملة العربية ممكن يتلخبط. لما تكتب كلمة إنجليزية أو رقم جوه جملة عربية، الكمبيوتر محتاج يعرف يعرض كل جزء في أنهي اتجاه. وUnicode عنده خوارزمية كاملة لده اسمها Bidirectional Algorithm (خوارزمية الاتجاهين)، وأي برنامج بيعرض العربي لازم يمشي عليها. ولما المعلومات اللي حوالين الكلمة مش كفاية، ممكن الترتيب يطلع غلط، زي إن «16 GB» تظهر «GB 16». وفي موقعنا بنستخدم عناصر خاصة في HTML علشان نتجنب المشكلة دي.
أخطاء شائعة
- «الملف اللي ظاهر فيه رموز غريبة بايظ»: غالبًا لأ.
البيانات سليمة، بس البرنامج بيقراها بـ Encoding غير اللي اتحفظت بيه. - «Unicode وUTF-8 حاجة واحدة»: غلط.
Unicode جدول بيدّي كل حرف رقم، وUTF-8 طريقة لتخزين الرقم ده كبايتات. - «كل حرف = بايت واحد»: ده كان صح في ASCII بس.
في UTF-8 الحرف العربي بياخد 2 بايت، والإيموجي 4. - «الحرف العربي ليه 4 أرقام مختلفة علشان ليه 4 أشكال»: غلط.
الحرف ليه رقم واحد في Unicode، والخط هو اللي بيختار الشكل. - «التشكيل جزء من الحرف»: غلط.
كل علامة تشكيل رمز منفصل ليه رقمه الخاص.
المصطلحات
- ترميز الحروف (Character Encoding): الطريقة المتفق عليها لتحويل الحروف إلى أرقام وبايتات، ثم إعادتها حروفًا عند العرض.
- آسكي (ASCII): ترميز قديم يستخدم 7 بتات ويضم 128 رمزًا، وليس فيه حروف عربية.
- يونيكود (Unicode): معيار عالمي يعطي كل حرف في لغات العالم رقمًا ثابتًا.
- نقطة الترميز (Code Point): الرقم الذي يعطيه Unicode لحرف معيّن، ويُكتب بالشكل U+ ثم رقم سداسي عشر.
- UTF-8 (UTF-8): طريقة لتخزين أرقام Unicode، يأخذ فيها الحرف من 1 إلى 4 بايتات، وهي الترميز الموصى به على الويب.
اختبر نفسك
كلمة «سلام» بتاخد كام بايت في UTF-8؟
8 بايت.
الكلمة فيها 4 حروف عربية، وكل حرف عربي أساسي بياخد 2 بايت في UTF-8.
يعني 4 × 2 = 8.
إظهار الإجابة
الإجابة الصحيحة: 8 بايت
8 بايت.
الكلمة فيها 4 حروف عربية، وكل حرف عربي أساسي بياخد 2 بايت في UTF-8.
يعني 4 × 2 = 8.
فتحت ملف لقيت العربي فيه ظاهر رموز لاتينية غريبة كتير فيها حرف Ø. إيه السبب غالبًا؟
الملف محفوظ بـ UTF-8، لكن البرنامج بيقراه بـ Encoding غربي قديم (زي Windows-1252).
البيانات سليمة، والحل إن الملف يتفتح بـ UTF-8.
إظهار الإجابة
الإجابة الصحيحة: الملف UTF-8 والبرنامج بيقراه بـ Encoding غربي قديم
الملف محفوظ بـ UTF-8، لكن البرنامج بيقراه بـ Encoding غربي قديم (زي Windows-1252).
البيانات سليمة، والحل إن الملف يتفتح بـ UTF-8.
حرف A رقمه كام في ASCII؟ وبياخد كام بايت في UTF-8؟
رقمه 65، وبياخد بايت واحد.
حروف ASCII بتتخزن في UTF-8 زي ما هي بالظبط، وده اللي بيخلي UTF-8 متوافق مع ASCII.
إظهار الإجابة
الإجابة الصحيحة: رقمه 65، وبياخد بايت واحد
رقمه 65، وبياخد بايت واحد.
حروف ASCII بتتخزن في UTF-8 زي ما هي بالظبط، وده اللي بيخلي UTF-8 متوافق مع ASCII.